좌석 조회의 반복 작업을 Caffeine 캐시로 줄이고, nginx 연결을 재사용하도록 개선했다. Redis 기반 가상 대기실을 구현해, 정원을 넘는 사용자는 순번을 안내받으며 기다리고 빈자리가 생기면 입장하도록 구성했다.
1. 문제 상황
티켓 예매 서비스의 좌석 선택 화면은 GET /api/schedules/{scheduleId}/seats를 3초 주기로 호출한다. 사용자가 머무르는 동안 다른 사용자의 선점·구매로 바뀐 좌석 상태를 갱신하기 위해서다.
이 글에서 말하는 동시 사용자는 좌석 페이지에 머무르며 폴링하는 사용자 수다. 서비스 전체 기능을 동시에 사용하는 인원이나 초당 요청 수를 의미하지 않는다.
2026년 9월 16일, 좌석 페이지 체류 사용자 수를 늘리며 k6 부하테스트를 진행했다. 개발 서버는 운영과 같은 EC2를 사용하고 있어 Docker의 CPU 상한을 cpus: 1.5로 제한한 상태였다. 백엔드는 Spring Boot와 PostgreSQL을 사용했다.
목표는 클라이언트 응답 p95 1초 미만, 요청 실패율 1% 미만이었다. 하지만 사용자가 늘자 처리량은 더 이상 증가하지 않고 대기 시간만 길어졌다.
| 체류 사용자 | 서버 처리량 | 클라이언트 응답 p95 | 요청 실패율 |
|---|---|---|---|
| 600명 | 197 req/s | 99ms | 0% |
| 900명 | 287 req/s | 494ms | 0% |
| 1,200명 | 325 req/s | 1.73초 | 0% |
| 2,400명 | 274 req/s | 7.08초 | 4.0% |
1,200명부터 처리량이 약 320 req/s 부근에서 정체됐고, 2,400명에서는 오히려 감소했다. 이 구간의 실패는 k6의 10초 요청 타임아웃으로 기록됐다. 초기 측정에서는 서버 5xx와 nginx 에러가 없었지만, 사용자 입장에서는 좌석 상태 갱신이 늦어지는 문제가 발생할 수 있었다.
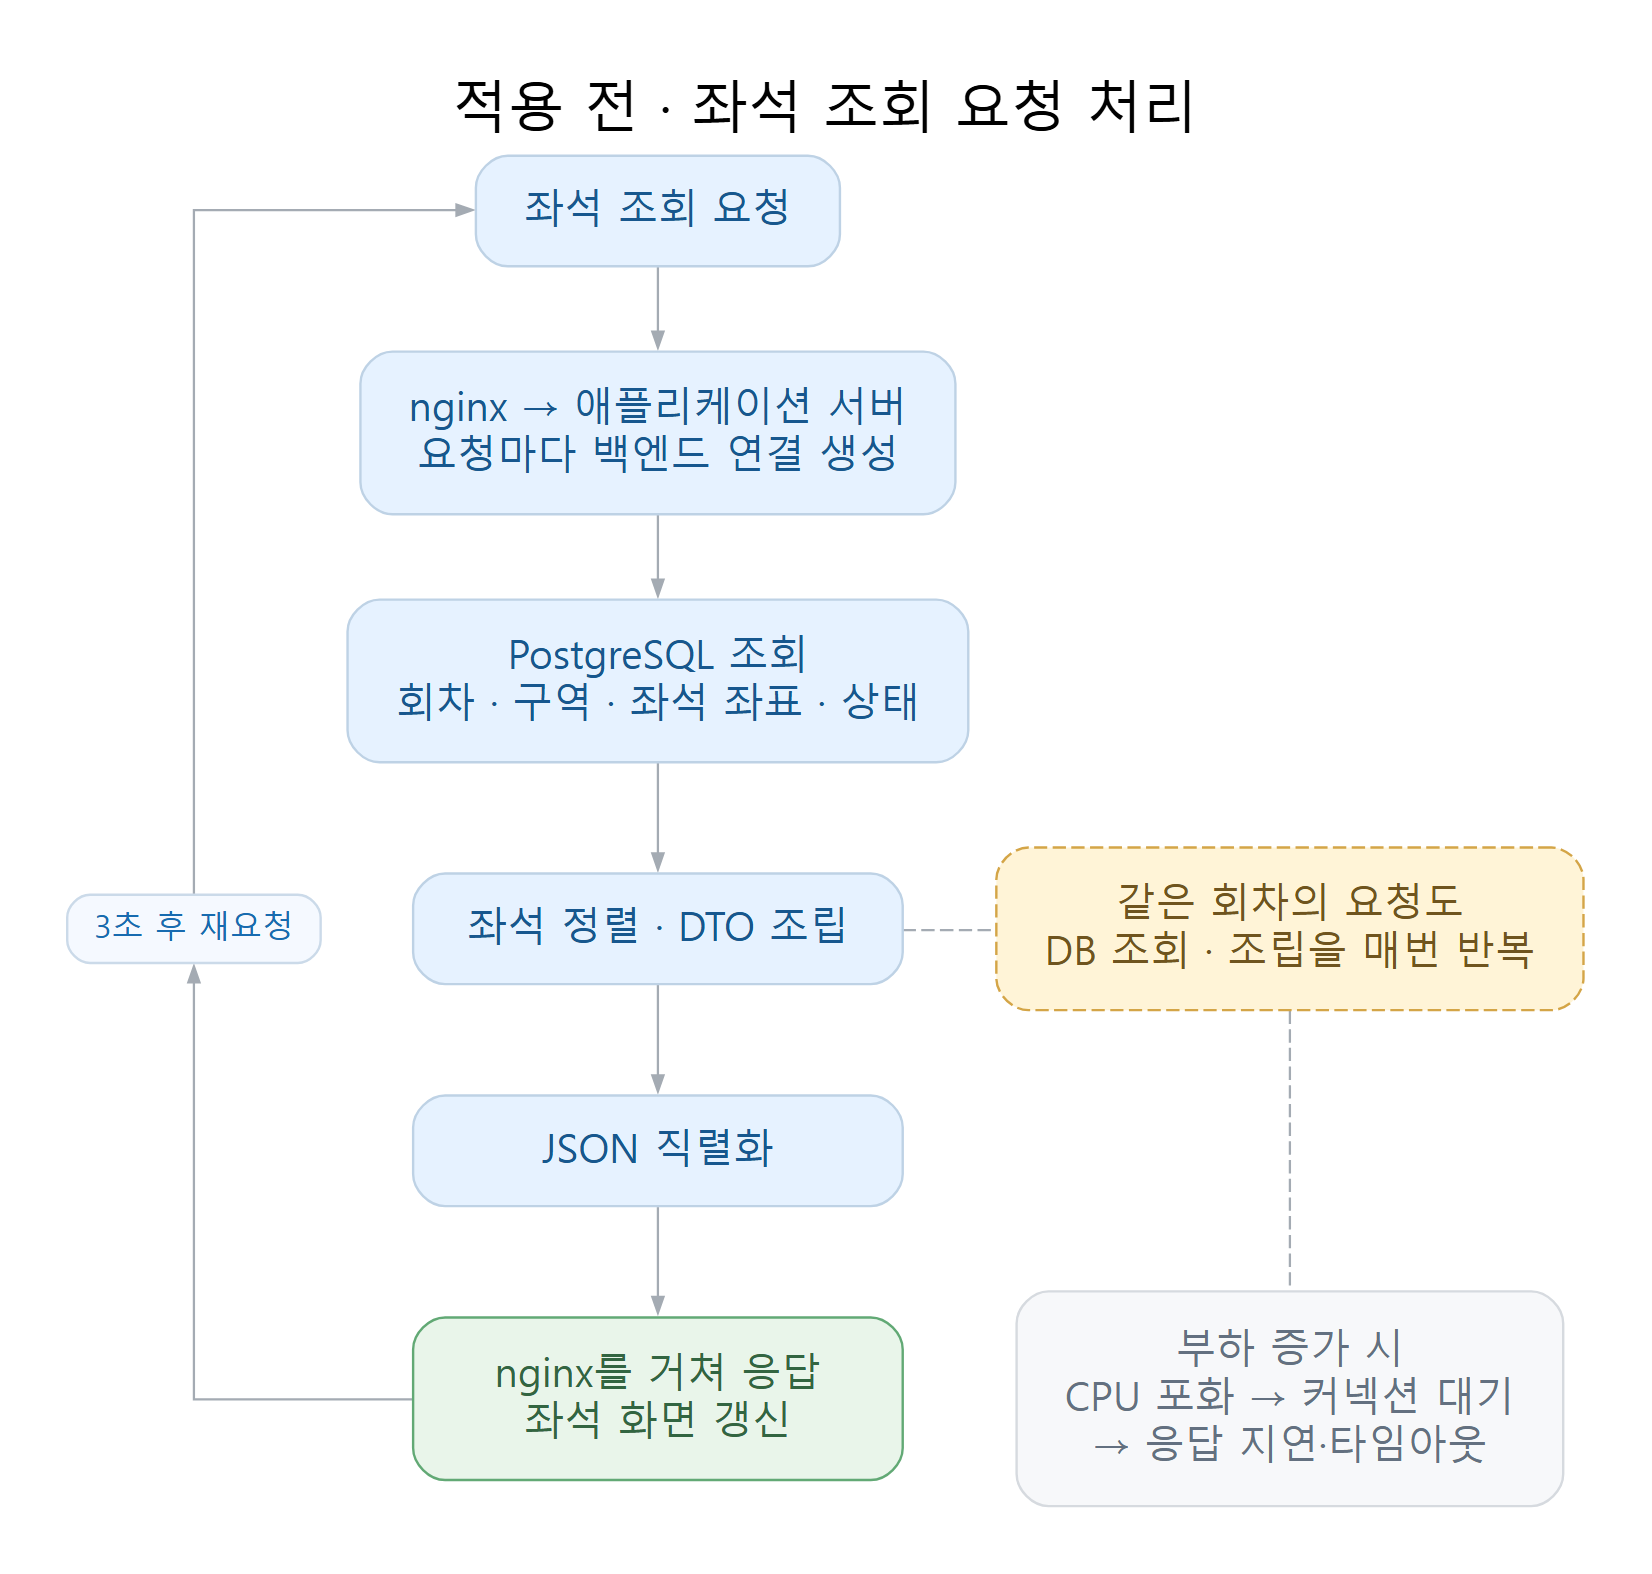
적용 전에는 같은 회차를 보는 요청도 조회·조립을 반복했고, nginx와 백엔드 사이의 연결도 재사용하지 않았다.
2. 원인 파악
처음에는 DB 커넥션 풀 부족을 의심했다.
900명 구간에서 HikariCP의 사용 중 커넥션이 최대치인 10개에 도달했고, 커넥션 대기 요청도 83개까지 증가했다. 1,200명부터는 처리 중 요청 수가 200에 도달했다.
다만 600명까지는 최대 3개의 커넥션으로 처리하고 있었다. 풀 크기를 바로 늘리기보다, 부하가 커졌을 때 커넥션을 오래 점유하는 이유부터 확인했다.
커넥션 점유 시간은 늘었지만, DB 자체가 포화된 모습은 아니었다.
당시 측정 기록에서 커넥션을 빌린 뒤 반환하기까지의 시간과, 빌리기 위해 기다린 시간을 나눠 보았다.
| 지표 | 600명 | 2,400명 |
|---|---|---|
| 평균 커넥션 점유 시간 | 8.3ms | 32.9ms |
| 평균 커넥션 획득 대기 시간 | 1.4ms | 682.3ms |
같은 시점에 PostgreSQL의 활성 쿼리는 0 ~ 1개였고, 쿼리 응답도 ms 단위를 유지했다. 반면 애플리케이션의 JVM CPU 지표는 900명부터 98 ~ 100%에 도달했고, 컨테이너의 cpu.stat에서도 CPU 스로틀링이 관찰됐다.
코드를 확인하니 좌석맵 조회는 회차, 공연 구역 설정, 좌석 좌표, 좌석 상태를 읽은 뒤 구역별 정렬과 DTO 매핑을 수행하고 있었다. 같은 회차와 구역을 조회하는 사용자에게도 이 작업을 매번 반복하는 구조였다.
이를 종합해 반복되는 조회·조립 작업과 CPU 제한을 주요 병목으로 판단했다. CPU를 할당받지 못하는 시간이 늘면 트랜잭션 종료와 커넥션 반환도 늦어질 수 있고, 그 결과 커넥션 대기와 요청 적체가 함께 커진다고 해석했다.
좌석맵 조회·조립 반복
→ 앱 서버 CPU 포화와 스로틀링
→ 커넥션 점유 시간 증가
→ 커넥션 대기와 처리 중 요청 증가
→ 응답 지연 및 클라이언트 타임아웃
Hikari 대기는 직접 관찰한 현상이지만, 그것만으로 풀 크기가 근본 원인이라고 결론 내릴 수는 없었다. 또한 이 기록만으로 전체 지연 중 정확히 얼마가 Tomcat accept 큐에서 발생했는지까지 단정하지는 않았다.
캐시 적용 후에는 nginx의 백엔드 연결 생성이 다음 병목으로 드러났다.
캐시 적용 뒤 서버 내부 응답은 빨라졌지만, 외부 경로로 요청하는 테스트에서는 1,800명 구간에 nginx 502가 발생했다. 당시 서버 p95는 22ms였지만 클라이언트 p95는 3.43초였고, nginx에는 다음 오류가 기록됐다.
connect() failed (99: Cannot assign requested address)당시 측정 기록에서는 upstream 연결의 TIME_WAIT 누적과 임시 포트 고갈을 확인했다. 애플리케이션의 반복 연산을 줄인 뒤에도, nginx가 백엔드에 새 연결을 계속 만드는 비용을 해결해야 했다.
처리 비용을 줄인 뒤에도, 감당할 수 있는 인원보다 더 많이 들어오는 문제는 남았다.
뒤에서 정리할 최적화 후 측정에서도 6,000명 구간은 응답 시간 목표를 넘었고, 9,000명에서는 타임아웃이 다시 발생했다. 따라서 조회 성능을 높이는 작업에 더해, 좌석 페이지 입장 인원을 조절할 장치가 필요했다. 서버 안에서 요청이 적체될 때까지 기다리는 대신, 초과 사용자는 가상 대기실에서 순번을 안내받도록 설계했다.
3. 해결 방법
해결 방향은 세 가지로 나눴다. 캐시는 반복 연산을 줄이고, nginx keepalive는 연결 생성 비용을 줄이며, 가상 대기실은 좌석 페이지의 입장 인원을 조절한다.
3-1. 좌석 조회 캐시로 반복 연산 줄이기
CPU나 커넥션 풀을 늘리기에 앞서, 같은 응답을 만들기 위해 반복하던 작업을 줄이기로 했다. Caffeine에 ScheduleSeatMapResponse DTO를 저장하고, 캐시가 없거나 만료됐을 때 기존 조회·조립 로직을 실행하도록 변경했다.
캐시 접근은 SeatMapCacheRepository에 모았다. TTL은 기본 1초, 최대 엔트리 수는 200개로 설정에서 조절할 수 있게 했다. 핵심 코드는 다음과 같다.
this.cache = Caffeine.newBuilder()
        .expireAfterWrite(ttl)
        .maximumSize(maxEntries)
        .recordStats()
        .build();

public ScheduleSeatMapResponse get(Long scheduleId, Long areaId,
        Supplier<ScheduleSeatMapResponse> loader) {
    return cache.get(new Key(scheduleId, areaId), key -> loader.get());
}

private record Key(Long scheduleId, Long areaId) {
}
캐시 키에는 scheduleId와 areaId를 모두 포함했다. 같은 회차라도 전체 구역을 조회하는 요청과 특정 구역만 조회하는 요청의 응답이 다르기 때문이다.
만료 기준은 expireAfterWrite를 사용했다. 조회할 때마다 유효 시간이 연장되는 방식이면 인기 회차의 오래된 좌석 상태가 계속 남을 수 있으므로, 저장 시점부터 1초가 지나면 만료되도록 했다.
또한 cache.get(key, loader)로 조회와 생성을 처리해, 같은 프로세스에서 같은 키의 캐시 미스가 동시에 발생해도 조회·조립 작업이 중복 실행되는 것을 막았다.
서비스에서는 기존 로직을 loadSeatMap()으로 분리하고 캐시 로더로 전달했다.
public ScheduleSeatMapResponse getSeatMap(Long scheduleId, Long areaId) {
    return withCurrentServerTime(
            seatMapCache.get(scheduleId, areaId,
                    () -> loadSeatMap(scheduleId, areaId)));
}
캐시가 적중하면 기존 좌석 조회·정렬·매핑을 건너뛰고, serverTime만 현재 시각으로 바꿔 응답한다. 캐시 대상은 DTO이므로 JSON 직렬화와 응답 전송은 요청마다 수행된다. serverTime을 갱신해도 캐시된 좌석 상태의 조회 시각이 바뀌는 것은 아니다.
좌석 변경 때마다 캐시를 무효화하는 로직은 추가하지 않았다. 쓰기가 몰릴 때 캐시가 계속 비워지는 것을 피하고, 짧은 TTL로 재사용 범위를 제한했다. 이 선택은 캐시 저장 후 최대 1초 동안 스냅샷을 재사용하는 대신 반복 연산을 줄이는 절충이다. 화면에는 폴링 대기와 응답 시간까지 더해지므로, 화면이 항상 1초 이내의 최신 상태라는 뜻은 아니다.
실제 선점 가능 여부는 기존 선점 API가 DB의 상태 조건을 포함한 UPDATE로 판단한다. 조회 캐시는 좌석 표시용으로 사용하고, 선점 성공 여부의 판단 근거로 사용하지 않았다.
3-2. nginx 연결 재사용으로 연결 생성 부담 줄이기
nginx의 API 프록시를 명시적인 upstream으로 구성하고, keepalive 32로 워커마다 유휴 백엔드 연결을 보관하도록 변경했다. HTTP/1.1과 빈 Connection 헤더도 함께 설정했다. 다음은 관련 설정을 발췌한 것이다.
upstream dev_api {
    zone dev_api 64k;
    resolver 127.0.0.11 valid=10s ipv6=off;
    server dev-server:8080 resolve;
    keepalive 32;
}

# server 블록 안의 API 프록시 설정
location /api/ {
    proxy_pass http://dev_api;
    proxy_http_version 1.1;
    proxy_set_header Connection "";
    # 그 외 전달 헤더와 타임아웃 설정은 생략
}
이 설정은 nginx와 애플리케이션 사이의 연결을 재사용하기 위한 것이다. 32는 워커당 보관할 유휴 연결 수이며 전체 동시 사용자 수의 상한이 아니다.
3-3. Redis 기반 가상 대기실로 입장 인원 조절하기
대기 순서와 입장 상태를 별도로 관리했다.
대기실의 상태는 Redis에 회차별로 저장했다. 현재 순번과 유효한 입장 인원을 계산하기 위해, 대기열과 입장 목록을 각각 Sorted Set으로 구성했다.
| 구분 | member | score | 용도 |
|---|---|---|---|
| 대기열 | 사용자 ID | 대기열 진입 시각 | 진입 시각을 기준으로 순번 계산 |
| 입장 목록 | 사용자 ID | 입장 만료 시각 | 현재 유효한 입장 인원 계산 |
대기열 등록에는 ZADD NX에 해당하는 addIfAbsent()를 사용했다. 이미 기다리는 사용자가 새로고침하거나 입장을 다시 요청해도 최초 진입 시각을 바꾸지 않아 순번을 유지한다. 순번은 ZRANK로 조회한다.
입장 인원은 별도 카운터를 증감하지 않고, 입장 목록에서 만료 시각이 현재보다 뒤인 사용자를 세도록 했다. 사용자가 브라우저를 닫아 정상적인 이탈 요청을 보내지 못해도, 입장 표식이 만료되면 다음 입장 처리에서 자리를 회수할 수 있다.
빈자리 계산부터 입장 등록까지 Lua로 묶었다.
빈자리를 확인한 뒤 사용자를 꺼내고 입장 목록에 넣는 작업을 따로 실행하면, 여러 실행이 같은 빈자리를 기준으로 입장자를 배정할 수 있다. 그래서 QueueRedisRepository에서 다음 과정을 하나의 Lua 스크립트로 실행했다.
만료된 입장자 정리
→ 현재 입장 인원 계산
→ 이번 입장 인원 = min(정원 - 현재 인원, 실행당 입장 상한)
→ 대기열 앞에서 사용자 꺼내기
→ 입장 목록에 만료 시각과 함께 등록
핵심 코드는 다음과 같다. 회차별 설정과 시간 값을 읽는 앞부분은 생략했다.
-- KEYS[1]: 대기열, KEYS[2]: 입장 목록
redis.call('ZREMRANGEBYSCORE', KEYS[2], '-inf', now)
local current = redis.call('ZCOUNT', KEYS[2], now, '+inf')
local free = math.min(capacity - current, maxPerTick)
if free <= 0 then return {} end

local popped = redis.call('ZPOPMIN', KEYS[1], free)
local admitted = {}
for i = 1, #popped, 2 do
    redis.call('ZADD', KEYS[2], now + ttlMs, popped[i])
    admitted[#admitted + 1] = popped[i]
end
return admitted
Redis는 Lua 스크립트를 원자적으로 실행하므로, 이 입장 할당 과정 중간에 다른 명령이 끼어들지 않는다.
입장 관리자인 QueueAdmitter는 기본 1초 간격으로 실행을 시도하고, Redis의 만료 시간이 있는 SET NX 락을 얻은 경우 입장 처리를 진행한다. 블루·그린 배포 중 두 인스턴스의 입장 관리자가 겹쳐 실행되는 것을 줄이기 위한 장치다. 기본 정원은 회차당 5,000명, 입장 처리 한 번의 상한은 200명으로 두었다. 빈자리가 많아도 사용자가 한꺼번에 좌석맵 첫 조회를 시작하지 않도록 한 것이다. 이는 초당 200명 입장을 보장하는 값이 아니라 실행당 상한이다.
프런트 화면 이동과 서버의 접근 제어를 함께 구현했다.
대기 화면은 서버가 내려준 pollAfterSec에 따라 5~10초마다 상태를 조회한다. 응답의 순번·예상 대기 시간을 표시하고, admitted: true가 되면 구역 선택 화면으로 이동한다. 이 반복 상태 조회는 Redis를 사용하며 좌석맵 DB 조회·조립을 수행하지 않는다.
사용자가 대기 화면을 건너뛰어 API를 직접 호출할 수도 있으므로, 서버의 QueueAdmissionInterceptor에서도 좌석 조회와 등록된 좌석 선점 경로의 입장 표식을 확인한다. 미입장·만료·비로그인 요청에는 HTTP 428을 반환하고, 프런트는 대기실로 돌려보낸다. 유효한 입장자의 요청은 입장 만료 시각을 기본 10분 뒤로 연장한 다음 통과시킨다.
이렇게 대기 중인 사용자는 가벼운 상태 조회를 수행하고, 입장한 사용자의 좌석 조회에는 앞서 적용한 Caffeine 캐시를 사용하도록 연결했다.
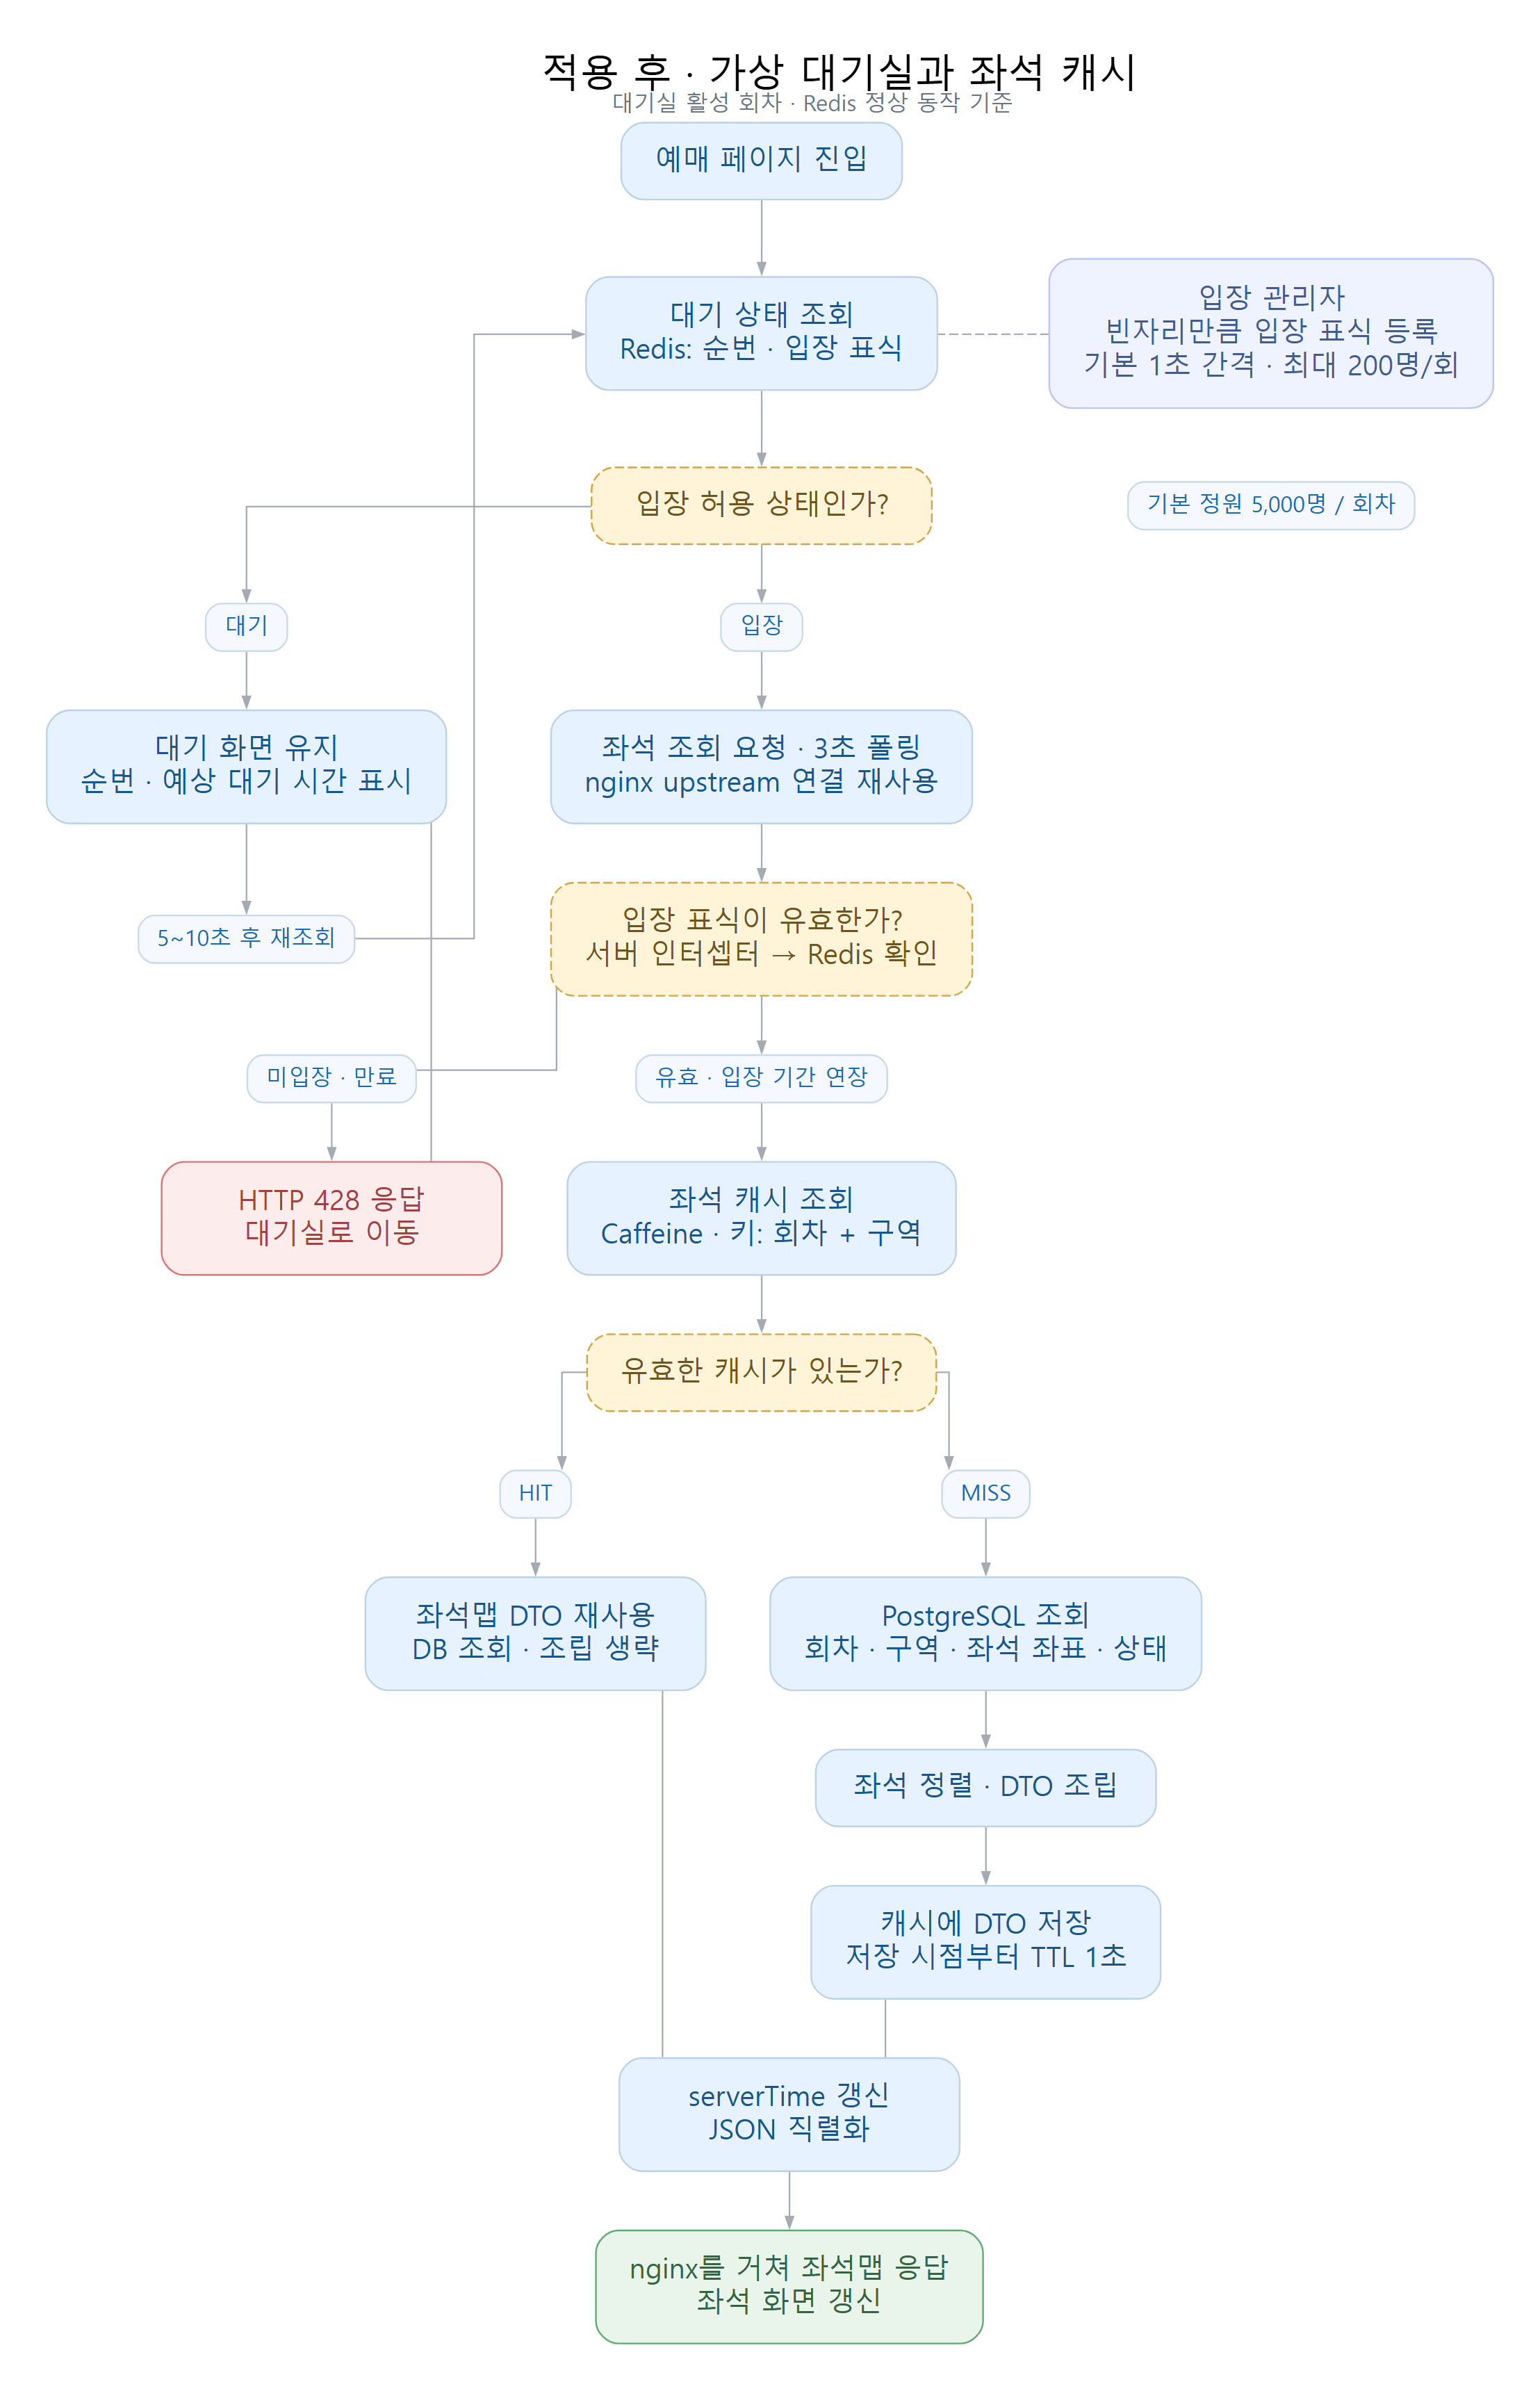
대기실을 활성화하고 Redis가 정상 동작하는 경우의 구조다. Redis는 대기열·입장 표식을, Caffeine은 좌석맵 DTO를 저장한다. 캐시가 적중해도 입장 검사와 JSON 직렬화는 매 요청 수행한다.
대기실은 회차별로 활성화하며, 비활성 상태나 입장 검사 중 Redis 오류가 발생한 경우에는 요청을 통과시킨다. 또한 회차별 정원은 서버 전체의 합산 입장 상한과 구분해야 한다.
Redis 장애 때는 좌석 조회 전체를 차단하는 대신 입장 제한을 일시적으로 포기하는 fail-open 정책을 선택한 것이다. 따라서 대기실의 정원 제한은 활성화 상태와 Redis 정상 동작을 전제로 하며, 운영에서는 대기 인원·입장 인원·거절 요청 수를 함께 확인해야 한다.
4. 배운 점
실제 운영할 서비스다보니 견고하게 서비스를 구축하는 것이 중요했고, 많은 동시 접속자가 티켓팅 서비스라는 특징을 고려하여 부하테스트를 진행했다.
부하테스트를 하며 설계 단계에서 고려하지 못한 문제를 맞닿뜨리고, 이를 해결해가는 과정에서 여러 상황을 고려한 설계의 중요함을 알게된 거 같다.